Local LLM Runtime Ubah Cara Menjalankan AI, Dari Server Cloud Menuju Komputasi Pribadi yang Lebih Mandiri

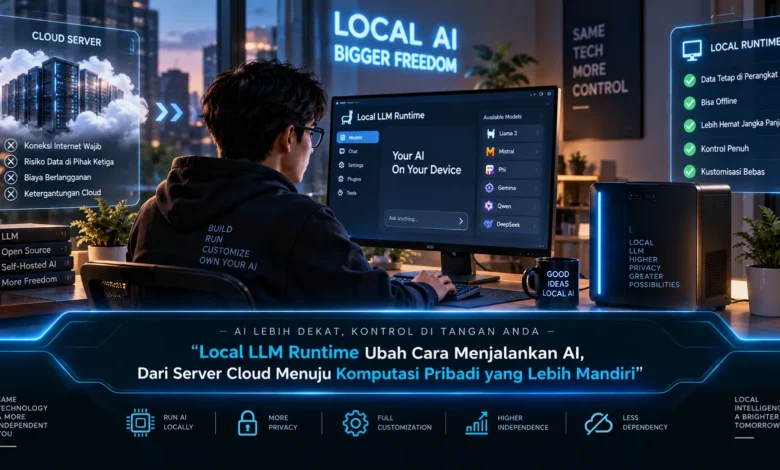
Local LLM Runtime mulai mengubah cara pengguna berinteraksi dengan kecerdasan buatan karena pemrosesan model kini tidak harus selalu bergantung pada server cloud. Dengan dukungan hardware yang semakin kuat, model AI dapat dijalankan langsung di laptop, mini PC, workstation, atau perangkat pribadi lain. Perubahan ini membuat TEKNOLOGI AI semakin dekat dengan pengguna karena kontrol terhadap data, performa, konfigurasi, dan penggunaan sumber daya dapat dilakukan secara lebih mandiri.
Local LLM Mengubah Arah Komputasi AI Menjadi Lebih Mandiri
AI lokal mulai berkembang sebagai alternatif karena model dapat diproses di laptop, mini PC, atau workstation tanpa harus terus terhubung ke server eksternal. Lapisan runtime membantu model bekerja dengan berbagai komponen perangkat keras yang tersedia pada sistem pengguna. Perubahan tersebut membuat TEKNOLOGI AI tidak lagi sepenuhnya identik dengan pusat data besar karena sebagian fungsi dapat dipindahkan menuju perangkat yang berada langsung di tangan pengguna.
Pengguna dapat menyesuaikan ukuran model, quantization, penggunaan memori, serta parameter lain sesuai kebutuhan pekerjaan. Komputasi lokal memberikan kontrol lebih luas dibandingkan layanan online yang sebagian besar pengaturannya berada di sisi penyedia. Fleksibilitas tersebut membuat TEKNOLOGI Local LLM menarik bagi pengguna yang ingin memiliki lingkungan AI yang dapat diatur sesuai pola kerja masing masing.
Laptop dan Mini PC Mulai Berubah Menjadi Pusat AI Lokal
Laptop dan mini PC generasi baru memiliki kemampuan komputasi yang semakin sesuai untuk menangani inferensi model bahasa secara lokal. GPU membantu mempercepat komputasi paralel sementara CPU tetap berguna untuk berbagai proses dan NPU mulai menjadi akselerator tambahan untuk beban AI tertentu. Kemajuan akselerator membuat TEKNOLOGI komputasi pribadi semakin siap menjadi fondasi AI lokal.
Mini PC dapat menjadi pilihan untuk membangun server AI pribadi tanpa harus menggunakan perangkat berukuran besar. Model dapat ditempatkan pada satu komputer utama lalu digunakan oleh laptop, tablet, atau perangkat lain di jaringan yang sama. Fleksibilitas komputasi membuat TEKNOLOGI Local LLM dapat disesuaikan dengan kebutuhan rumah, kantor, maupun lingkungan kerja kecil.
Model Besar Menjadi Lebih Praktis Berkat Quantization
Local LLM semakin mudah dijalankan karena quantization membantu mengecilkan kebutuhan RAM dan VRAM dibandingkan model dengan presisi lebih tinggi. Pengurangan kebutuhan sumber daya membuka peluang bagi lebih banyak perangkat untuk menjalankan model yang sebelumnya terlalu berat. Quantization membuat TEKNOLOGI AI lokal semakin mudah diakses oleh pengguna dengan perangkat konsumen modern.
Setiap tingkat quantization memiliki kompromi tertentu sehingga pengguna sebaiknya memilih berdasarkan jenis pekerjaan serta kemampuan perangkat. Untuk tugas sederhana model yang lebih ringan dapat terasa cukup sementara pekerjaan kompleks mungkin membutuhkan konfigurasi dengan kualitas representasi lebih tinggi. Kemampuan menyesuaikan model menjadikan TEKNOLOGI Local LLM semakin efisien untuk berbagai skenario komputasi pribadi.
Privasi dan Kontrol Data Menjadi Keunggulan Komputasi AI Lokal
Salah satu daya tarik Local LLM adalah kemampuan memproses data langsung di perangkat sehingga informasi tidak harus selalu dikirim menuju layanan cloud. AI lokal dapat digunakan untuk memproses berbagai data sensitif selama seluruh alur aplikasi benar benar berjalan di perangkat. Pendekatan tersebut membuat TEKNOLOGI Local LLM semakin menarik bagi pengguna yang membutuhkan kontrol lebih besar terhadap lokasi pemrosesan informasi.
Walaupun demikian AI lokal tidak otomatis berarti aman karena sistem operasi, runtime, model, dan aplikasi tetap perlu dilindungi. Model dan aplikasi sebaiknya digunakan dari sumber yang jelas sambil memastikan sistem operasi memiliki patch terbaru. Kombinasi kontrol data dan keamanan perangkat membuat TEKNOLOGI Local LLM memberikan manfaat privasi yang lebih nyata tanpa menciptakan rasa aman yang berlebihan.
Local LLM Membuka Penggunaan AI Tanpa Selalu Bergantung Internet
Pemrosesan lokal memungkinkan pengguna menjalankan berbagai fungsi AI tanpa harus mengirim setiap permintaan melalui jaringan. Berbagai tugas dapat dijalankan di perangkat selama model yang digunakan memang mampu menangani kebutuhan tersebut. Kemandirian dari internet membuat TEKNOLOGI Local LLM semakin relevan untuk komputasi pribadi yang fleksibel.
Model yang tersimpan pada perangkat dapat terus digunakan tanpa menunggu layanan online tersedia selama runtime berfungsi normal. Hal ini bukan berarti cloud tidak lagi diperlukan karena model yang sangat besar maupun fitur tertentu tetap lebih efisien dijalankan pada infrastruktur eksternal. Pendekatan hibrida memberi TEKNOLOGI AI kemampuan memilih lokasi pemrosesan berdasarkan kebutuhan performa, privasi, dan biaya.
Komputasi Lokal Membuka Banyak Fungsi AI untuk Pengguna
Penggunaan Local LLM mulai meluas karena model dapat diintegrasikan ke berbagai alur kerja pribadi seperti menulis, meringkas, mengolah dokumen, membantu coding, dan mengorganisasi informasi. Model dapat menjadi pendamping coding bagi programmer sekaligus asisten penulisan dan pengolahan dokumen bagi pengguna lain. Perluasan fungsi menjadikan TEKNOLOGI AI lokal tidak hanya menarik bagi eksperimen tetapi juga semakin relevan untuk produktivitas nyata.
Local LLM dapat digabungkan dengan sistem pencarian dokumen sehingga AI memperoleh konteks dari file yang memang dipilih pengguna. Pengaturan tersebut tetap perlu memperhatikan izin dan keamanan agar aplikasi hanya membaca folder maupun data yang memang diperlukan. Pengelolaan akses yang tepat membuat TEKNOLOGI AI lokal dapat memberikan manfaat besar tanpa mengabaikan privasi.
Kesimpulan Local LLM Runtime dan Masa Depan Komputasi AI Pribadi
Kemajuan runtime dan hardware membuat TEKNOLOGI AI semakin mampu berjalan pada laptop, mini PC, dan workstation tanpa selalu bergantung pada pusat data. CPU, GPU, NPU, kapasitas memori, serta teknik quantization menjadi bagian penting yang menentukan seberapa baik model dapat berjalan secara lokal. Local LLM menawarkan TEKNOLOGI yang memberikan pengguna kendali lebih besar terhadap data dan cara model dijalankan. Pendekatan hibrida membuat TEKNOLOGI AI dapat memilih antara kecepatan lokal dan kapasitas besar dari cloud. Dengan semakin kuatnya perangkat dan semakin efisiennya model, TEKNOLOGI AI lokal dapat menjadi fitur penting dalam pengalaman komputasi sehari hari. Pembaca dapat terus mengikuti perkembangan ini karena inovasi pada runtime, model, dan hardware akan menentukan seberapa jauh AI pribadi dapat bekerja semakin mandiri.


