Local LLM Runtime Ubah Cara Menjalankan AI, Dari Server Cloud Menuju Komputasi Pribadi yang Lebih Mandiri

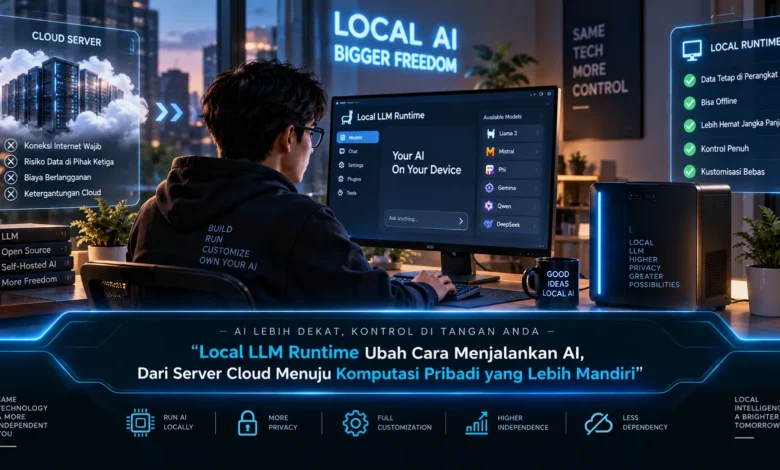
Local LLM Runtime mulai mengubah cara pengguna berinteraksi dengan kecerdasan buatan karena pemrosesan model kini tidak harus selalu bergantung pada server cloud. Dengan dukungan hardware yang semakin kuat, model AI dapat dijalankan langsung di laptop, mini PC, workstation, atau perangkat pribadi lain. Perubahan ini membuat TEKNOLOGI AI semakin dekat dengan pengguna karena kontrol terhadap data, performa, konfigurasi, dan penggunaan sumber daya dapat dilakukan secara lebih mandiri.
Pemrosesan AI Mulai Bergeser dari Server Cloud ke Komputer Lokal
Local LLM Runtime membuka pendekatan baru karena model bahasa dapat dijalankan langsung pada perangkat tanpa selalu mengandalkan layanan jarak jauh. Sistem runtime menjadi penghubung antara model AI dan hardware sehingga sumber daya komputasi dapat dimanfaatkan secara lebih efisien. Kemajuan ini membawa TEKNOLOGI kecerdasan buatan menuju pola komputasi yang lebih terdistribusi dan tidak selalu berpusat pada cloud.
Pemrosesan lokal juga memberikan pengalaman berbeda karena pengguna dapat memilih model, tingkat optimasi, panjang konteks, dan konfigurasi berdasarkan kebutuhan sendiri. Komputasi lokal memberikan kontrol lebih luas dibandingkan layanan online yang sebagian besar pengaturannya berada di sisi penyedia. Kebebasan memilih model menjadikan TEKNOLOGI Local LLM semakin cocok untuk kebutuhan AI pribadi yang lebih spesifik.
Laptop dan Mini PC Mulai Berubah Menjadi Pusat AI Lokal
Kemajuan hardware membuat komputer pribadi semakin mampu menjalankan model AI yang sebelumnya lebih banyak membutuhkan infrastruktur komputasi besar. Kombinasi CPU, GPU, dan NPU memungkinkan perangkat membagi beban komputasi sesuai dukungan runtime serta jenis model. Perkembangan tersebut membuat TEKNOLOGI komputer pribadi semakin bergerak dari sekadar perangkat produktivitas menjadi mesin AI yang dapat bekerja secara lokal.
Mini PC dapat menjadi pilihan untuk membangun server AI pribadi tanpa harus menggunakan perangkat berukuran besar. Satu sistem dapat menjalankan model kemudian perangkat lain mengaksesnya melalui antarmuka lokal sesuai konfigurasi pengguna. Fleksibilitas komputasi membuat TEKNOLOGI Local LLM dapat disesuaikan dengan kebutuhan rumah, kantor, maupun lingkungan kerja kecil.
Quantization Membuat Model AI Lebih Ringan untuk Hardware Lokal
Teknik optimasi seperti quantization memungkinkan model menggunakan format yang lebih ringan sehingga perangkat lokal dapat menanganinya dengan lebih efisien. Optimasi dapat membuat model berukuran besar lebih mudah dimuat pada laptop atau mini PC dengan kapasitas memori terbatas. Quantization membuat TEKNOLOGI AI lokal semakin mudah diakses oleh pengguna dengan perangkat konsumen modern.
Pemilihan format model perlu mempertimbangkan performa sekaligus kualitas hasil karena optimasi yang terlalu agresif dapat memberikan karakter respons yang berbeda. Pengguna dapat memilih format model sesuai tingkat kesulitan pekerjaan sehingga sumber daya perangkat tidak digunakan secara berlebihan. Kemampuan menyesuaikan model menjadikan TEKNOLOGI Local LLM semakin efisien untuk berbagai skenario komputasi pribadi.
Privasi dan Kontrol Data Menjadi Keunggulan Komputasi AI Lokal
Pemrosesan lokal memberikan pilihan bagi pengguna untuk menjaga dokumen dan permintaan tetap berada di komputer selama aplikasi memang dirancang bekerja secara lokal. Pengguna dapat memanfaatkan model lokal untuk membaca file, membantu penulisan, atau menganalisis kode tanpa selalu memindahkan informasi ke layanan jarak jauh. Privasi menjadi nilai tambah TEKNOLOGI AI lokal karena pengguna dapat menentukan dengan lebih jelas di mana data diproses.
Local LLM masih memerlukan perlindungan sistem karena data dapat tetap berisiko apabila komputer sudah terkompromi. Runtime sebaiknya diperoleh dari sumber terpercaya dan sistem perlu mendapatkan pembaruan keamanan secara berkala. Pengelolaan yang baik membuat TEKNOLOGI Local LLM semakin cocok digunakan sebagai lingkungan AI pribadi yang tetap berada dalam kendali pengguna.
Local LLM Membuka Penggunaan AI Tanpa Selalu Bergantung Internet
Kemampuan menjalankan model secara lokal membuat beberapa fungsi AI dapat tetap digunakan meskipun koneksi internet sedang terbatas atau tidak tersedia. Model lokal dapat membantu berbagai aktivitas produktivitas seperti menyusun teks, membaca dokumen, atau mendukung pemrograman tanpa koneksi terus menerus. Kemampuan ini membuat TEKNOLOGI Local LLM berguna untuk pengguna yang membutuhkan AI saat bepergian maupun berada di lingkungan dengan konektivitas tidak stabil.
Model yang tersimpan pada perangkat dapat terus digunakan tanpa menunggu layanan online tersedia selama runtime berfungsi normal. Komputasi lokal tidak sepenuhnya menggantikan cloud karena kebutuhan sumber daya tertentu tetap lebih cocok menggunakan pusat data. Local LLM dan cloud dapat saling melengkapi sehingga TEKNOLOGI kecerdasan buatan memiliki pilihan arsitektur yang semakin luas.
Komputasi Lokal Membuka Banyak Fungsi AI untuk Pengguna
AI lokal semakin sering dipakai sebagai asisten produktivitas yang dapat membantu pengguna menangani teks, kode, file, maupun catatan langsung dari komputer. Model dapat menjadi pendamping coding bagi programmer sekaligus asisten penulisan dan pengolahan dokumen bagi pengguna lain. Perluasan fungsi menjadikan TEKNOLOGI AI lokal tidak hanya menarik bagi eksperimen tetapi juga semakin relevan untuk produktivitas nyata.
Model lokal dapat memanfaatkan sumber informasi pribadi untuk membantu menjawab pertanyaan yang berkaitan dengan pekerjaan atau arsip pengguna. Pengaturan tersebut tetap perlu memperhatikan izin dan keamanan agar aplikasi hanya membaca folder maupun data yang memang diperlukan. Kombinasi model dan data lokal menjadikan TEKNOLOGI Local LLM semakin dekat dengan konsep asisten komputasi pribadi yang benar benar terintegrasi.
Kesimpulan Local LLM sebagai Fondasi Komputasi yang Lebih Mandiri
Local LLM Runtime mengubah cara menjalankan kecerdasan buatan karena sebagian proses yang sebelumnya identik dengan server cloud kini dapat dilakukan langsung pada perangkat pribadi. CPU, GPU, NPU, kapasitas memori, serta teknik quantization menjadi bagian penting yang menentukan seberapa baik model dapat berjalan secara lokal. Kemandirian dari cloud membuat TEKNOLOGI Local LLM semakin relevan untuk pengguna yang mengutamakan privasi dan fleksibilitas. Pendekatan hibrida membuat TEKNOLOGI AI dapat memilih antara kecepatan lokal dan kapasitas besar dari cloud. Jika hardware dan software terus berkembang seimbang, TEKNOLOGI Local LLM berpotensi menjadi bagian standar dari komputer pribadi generasi berikutnya. Evolusi TEKNOLOGI Local LLM menarik untuk diperhatikan karena setiap peningkatan efisiensi dapat membuka penggunaan baru di perangkat lokal.