Tips Menjalankan LLM Offline Lebih Efisien, Dari Quantization hingga Pengaturan CPU dan GPU yang Tepat

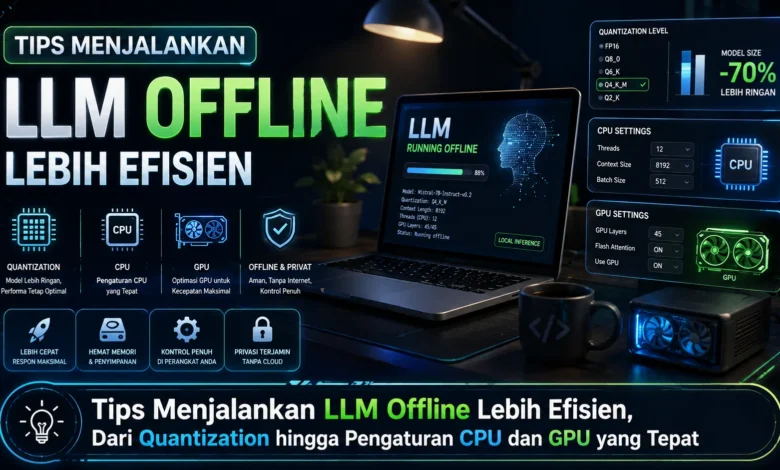
Menjalankan Large Language Model atau LLM secara offline semakin menarik bagi pengguna yang menginginkan kontrol lebih besar terhadap data, privasi, dan lingkungan AI yang digunakan. Tantangannya, model AI dapat membutuhkan RAM, VRAM, serta kemampuan komputasi yang cukup besar apabila konfigurasi tidak disesuaikan dengan perangkat. Pemilihan model, quantization, context window, hingga pembagian beban antara CPU dan GPU menjadi bagian penting agar sistem tetap responsif. Dengan pengaturan yang tepat, TEKNOLOGI AI lokal dapat berjalan lebih efisien bahkan pada laptop atau PC yang tidak menggunakan hardware kelas atas.
Sesuaikan Model AI dengan Kapasitas Hardware yang Tersedia
Hal pertama sebelum menggunakan model lokal adalah memahami kebutuhan resource model. Model AI dengan kebutuhan komputasi tinggi biasanya memberikan beban lebih berat terhadap hardware. Menjalankan LLM di luar kapasitas komputer dapat membuat sistem kurang responsif dan meningkatkan kemungkinan proses terhenti.
LLM dengan parameter lebih ringkas dapat menawarkan pengalaman yang lebih efisien untuk chat lokal, eksperimen coding. Jumlah parameter bukan satu satunya penentu kualitas, karena arsitektur model juga berperan terhadap hasil model. Melalui pemilihan yang seimbang, TEKNOLOGI LLM offline dapat berjalan lebih lancar.
Model Terkuantisasi Membuat LLM Offline Lebih Ringan
Quantization menjadi strategi yang sangat berguna untuk menekan resource yang diperlukan ketika inferensi. Dalam penerapannya, teknik ini mengurangi presisi bobot model, sehingga ukuran model dapat diperkecil. Keuntungan tersebut membuat model yang sebelumnya terlalu berat dapat menjadi lebih mudah dijalankan.
Format kuantisasi sebaiknya tidak hanya ditentukan berdasarkan ukuran file. Kompresi parameter yang lebih kuat dapat membantu perangkat dengan resource terbatas, tetapi berpotensi mempengaruhi kualitas keluaran. Oleh sebab tersebut, pengguna sebaiknya memilih format berdasarkan penggunaan nyata hingga memperoleh konfigurasi yang sesuai dengan kapasitas perangkat.
Batasi Panjang Konteks Sesuai Kebutuhan Penggunaan
Context window menentukan berapa banyak informasi yang dapat dipertahankan model. Pengaturan konteks yang sangat besar memang berguna untuk dokumen panjang, tetapi juga dapat menambah beban inferensi. Pada laptop dengan RAM terbatas, menggunakan context maksimal sepanjang waktu dapat membuat sistem lebih berat.
Pada tugas menulis singkat, panjang konteks secukupnya sering lebih praktis. Panjang konteks bisa dinaikkan untuk pekerjaan tertentu daripada langsung menggunakan nilai tertinggi. Pendekatan sederhana ini membantu mengendalikan konsumsi RAM dan VRAM sekaligus membuat inferensi lokal terasa lebih responsif.
Pembagian CPU dan GPU Menentukan Efisiensi Inferensi
GPU dapat meningkatkan kecepatan pemrosesan LLM apabila model dan runtime mendukung. Namun, GPU kelas konsumen sering memiliki batas memori tertentu. Apabila kebutuhan memori terlalu besar, pengguna dapat membagi pekerjaan antara CPU dan GPU daripada memaksakan seluruh model berada di GPU.
Besarnya porsi GPU offloading dapat ditingkatkan atau dikurangi. Ketika kartu grafis belum mencapai batasnya, lebih banyak bagian model dapat diproses melalui GPU. Sebaliknya, jika VRAM hampir penuh, sebagian pemrosesan dapat tetap berada pada CPU dan RAM. Pengaturan yang seimbang dapat menghasilkan pengalaman inferensi yang lebih nyaman.
Efisiensi LLM Juga Bergantung pada Software dan Kondisi Sistem
Konfigurasi CPU serta GPU bukan seluruh solusi untuk meningkatkan efisiensi. Runtime yang digunakan juga dapat mempengaruhi penggunaan resource. Runtime yang efisien dapat mengurangi overhead yang tidak diperlukan, sehingga resource komputer digunakan secara lebih proporsional.
Penggunaan RAM oleh program lain juga perlu diperhatikan. Aplikasi berat di latar belakang dapat mengurangi resource untuk model. Mengurangi proses background merupakan langkah sederhana tetapi berguna. Dengan menggabungkan optimasi software dan hardware, TEKNOLOGI AI lokal dapat berjalan lebih efisien.
Kesimpulan, LLM Lokal Bisa Berjalan Nyaman dengan Konfigurasi yang Seimbang
Mengoptimalkan AI lokal memerlukan konfigurasi yang sesuai dengan kemampuan perangkat. Pemilihan ukuran model, kuantisasi parameter, pengaturan context window, serta pembagian CPU dan GPU dapat meningkatkan efisiensi inferensi. Tidak selalu diperlukan hardware termahal selama pengguna memahami batas hardware.
Seiring waktu, TEKNOLOGI LLM lokal kemungkinan menjadi semakin mudah digunakan melalui runtime inferensi yang lebih matang. Menurut Anda, optimasi mana yang paling membantu menjalankan AI lokal, apakah quantization? Berikan perspektif Anda mengenai penggunaan AI offline dan ikuti inovasi selanjutnya untuk mengetahui teknik optimasi lainnya.