Tips Mengoptimalkan GPU untuk AI agar Stabil, Strategi Praktis Tingkatkan Kecepatan Pemrosesan

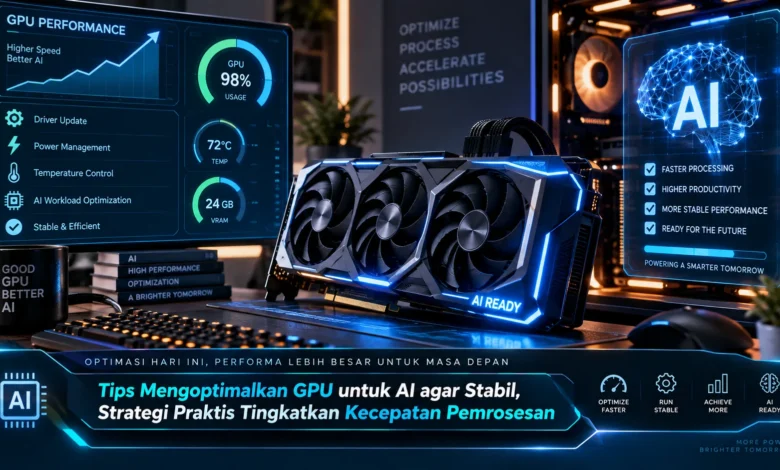
GPU menjadi komponen penting ketika menjalankan berbagai workload AI karena mampu menangani banyak operasi komputasi secara paralel. Namun, kartu grafis dengan spesifikasi tinggi belum tentu memberikan performa maksimal apabila VRAM, suhu, driver, framework, hingga konfigurasi model tidak dikelola dengan tepat. Optimasi yang seimbang dapat membantu meningkatkan kecepatan sekaligus menjaga stabilitas sistem, sehingga pemanfaatan TEKNOLOGI AI menjadi lebih efisien untuk inferensi maupun pekerjaan komputasi lainnya.
Pahami Karakter Workload AI agar GPU Bekerja Optimal
Tahap pertama untuk meningkatkan performa kartu grafis dimulai dengan mengenali bagaimana aplikasi AI memanfaatkan sumber daya. Masing masing workload mempunyai karakteristik penggunaan hardware yang tidak sama. Sebagian model lebih banyak membutuhkan kapasitas VRAM, sedangkan workload berbeda dapat lebih bergantung pada throughput komputasi.
Pemantauan hardware membantu melihat bagaimana sumber daya digunakan. Utilisasi GPU, penggunaan VRAM, aktivitas CPU, RAM, temperatur, serta kecepatan pemrosesan sebaiknya diamati selama model melakukan inferensi. Apabila utilisasi kartu grafis rendah tetapi prosesor terus berada pada beban berat, hambatan performa mungkin bukan berasal dari kartu grafis. Cara seperti ini membantu pengguna meningkatkan performa TEKNOLOGI secara lebih efektif.
Manajemen Memory GPU Menjadi Kunci Performa AI
VRAM menjadi salah satu sumber daya terpenting ketika menjalankan model AI berukuran besar. Bobot model menggunakan sebagian kapasitas memory, sementara proses inferensi juga menghasilkan kebutuhan memory tambahan. Jika seluruh kapasitas VRAM sudah digunakan sejak awal, model dapat mengalami masalah saat membutuhkan alokasi tambahan.
Pengguna dapat mengurangi aplikasi lain yang memakai akselerasi GPU. Peramban, perangkat lunak grafis, permainan, software editing, serta aplikasi visual dapat mengambil sebagian VRAM tanpa disadari. Memberikan ruang cadangan pada VRAM dapat membantu mempertahankan stabilitas ketika kebutuhan workload berubah. Strategi penggunaan VRAM tersebut menjadi salah satu cara praktis mengoptimalkan TEKNOLOGI AI.
Quantization Membuat Model Lebih Ringan untuk GPU
Teknik representasi numerik yang lebih ringkas dapat digunakan dalam menekan konsumsi VRAM. Model dengan representasi numerik yang lebih tinggi cenderung mengonsumsi VRAM dalam jumlah lebih besar. Menerapkan format model yang lebih ringan dapat mengurangi ukuran serta kebutuhan memory.
Konfigurasi quantization perlu dipilih berdasarkan workload. Pengaturan yang lebih agresif dapat memberikan penghematan memory lebih besar, tetapi kualitas atau konsistensi output dapat berubah. Pengujian beberapa konfigurasi dapat membantu menemukan keseimbangan antara kualitas dan performa. Tujuan akhirnya ialah menjaga keseimbangan antara penggunaan VRAM, kecepatan, dan hasil.
Atur Batch dan Context agar Pemrosesan Lebih Efisien
Ukuran batch dapat menentukan bagaimana sumber daya grafis dimanfaatkan. Ukuran batch yang lebih tinggi berpotensi meningkatkan jumlah data yang diproses dalam satu periode, meski tekanan terhadap memory GPU juga menjadi lebih besar. Menggunakan batch terlalu besar dapat menimbulkan masalah ketika workload semakin berat.
Jumlah context dapat memberikan pengaruh besar terhadap penggunaan sumber daya. Jumlah token yang besar berpotensi menambah konsumsi VRAM. Jika tugas hanya membutuhkan informasi terbatas, memaksakan context besar justru dapat memboroskan sumber daya. Menentukan nilai awal yang aman lalu menguji peningkatan secara perlahan dapat membantu menemukan titik performa yang stabil.
CPU RAM dan GPU Perlu Bekerja Secara Seimbang
Kemampuan komputasi kartu grafis bukan satu satunya faktor ketika komponen lain tidak mampu menyediakan data dengan cukup cepat. CPU dapat menjalankan preprocessing serta berbagai tugas pendukung, sedangkan memory sistem dan penyimpanan menjadi sumber data. Jika salah satu bagian tersebut terlalu lambat, GPU dapat menunggu data meskipun memiliki kemampuan komputasi tinggi.
Offloading juga perlu dikelola dengan tepat. Ketika kebutuhan model lebih besar daripada VRAM yang tersedia, offloading dapat digunakan agar workload tetap berjalan. Akan tetapi transfer informasi secara berulang berpotensi menurunkan kecepatan pemrosesan. Pengaturan sumber daya yang tepat menjadi bagian penting dalam optimasi TEKNOLOGI AI.
Jaga Suhu dan Software agar GPU Tetap Stabil
GPU yang menjalankan workload AI dalam waktu panjang dapat menghasilkan panas dalam jumlah cukup besar. Jika suhu meningkat terlalu jauh, perangkat dapat menurunkan kecepatan untuk melindungi komponen. Kondisi tersebut dapat membuat inferensi yang awalnya cepat menjadi semakin lambat.
Airflow dan kebersihan perangkat menjadi bagian sederhana yang tidak boleh diabaikan. Komponen perangkat lunak perlu disesuaikan agar akselerasi berjalan dengan benar. Perangkat lunak GPU, runtime AI, serta library yang bekerja dengan baik berpotensi mengurangi masalah yang sebenarnya berasal dari software. Perpaduan pendinginan serta konfigurasi perangkat lunak tersebut menjadi fondasi untuk menjaga TEKNOLOGI AI tetap stabil dalam penggunaan panjang.
Kesimpulan
Optimalisasi kartu grafis untuk workload AI perlu memperhatikan performa sekaligus keandalan sistem. Kapasitas VRAM, format model, batch size, context, CPU, RAM, komunikasi antarperangkat, pendinginan, dan runtime perlu bekerja dalam konfigurasi yang sesuai. Dengan menyesuaikan setiap komponen berdasarkan kebutuhan workload, pengguna dapat meningkatkan kecepatan tanpa memberikan tekanan berlebihan pada sistem.
Monitoring menjadi bagian penting dalam menemukan konfigurasi terbaik. Konfigurasi terbaik dapat berubah sesuai model serta hardware yang digunakan, maka pengaturan sebaiknya disesuaikan berdasarkan hasil nyata. Pemanfaatan TEKNOLOGI kecerdasan buatan menjadi lebih efisien saat seluruh komponen bekerja selaras. Pembaca dapat menerapkan optimasi satu per satu untuk menemukan kombinasi kecepatan dan stabilitas terbaik pada perangkat masing masing.