Tips Menjalankan LLM Offline Lebih Efisien, Dari Quantization hingga Pengaturan CPU dan GPU yang Tepat

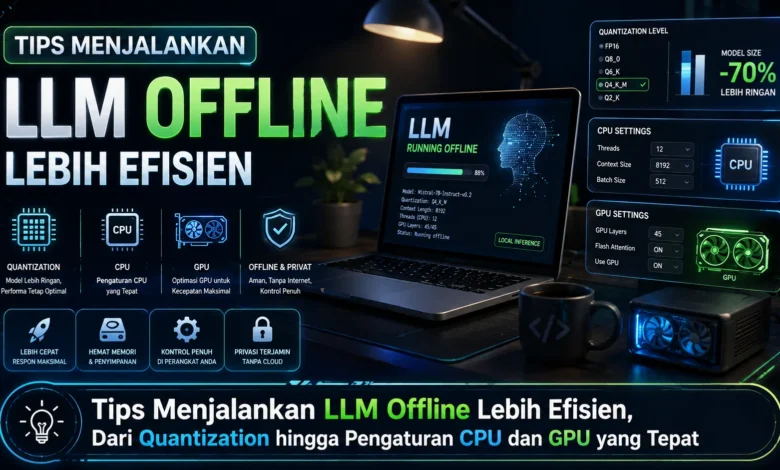
Menjalankan Large Language Model atau LLM secara offline semakin menarik bagi pengguna yang menginginkan kontrol lebih besar terhadap data, privasi, dan lingkungan AI yang digunakan. Tantangannya, model AI dapat membutuhkan RAM, VRAM, serta kemampuan komputasi yang cukup besar apabila konfigurasi tidak disesuaikan dengan perangkat. Pemilihan model, quantization, context window, hingga pembagian beban antara CPU dan GPU menjadi bagian penting agar sistem tetap responsif. Dengan pengaturan yang tepat, TEKNOLOGI AI lokal dapat berjalan lebih efisien bahkan pada laptop atau PC yang tidak menggunakan hardware kelas atas.
Pilih Model LLM yang Seimbang dengan Kemampuan Perangkat
Langkah pertama menjalankan LLM secara efisien adalah menyesuaikan LLM dengan kemampuan komputer. Model AI dengan kebutuhan komputasi tinggi biasanya memerlukan RAM dan VRAM lebih banyak. Menjalankan LLM di luar kapasitas komputer dapat membuat sistem kurang responsif dan mengurangi kenyamanan penggunaan.
Model AI berukuran moderat dapat menawarkan pengalaman yang lebih efisien untuk bantuan menulis, eksperimen coding. Jumlah parameter bukan satu satunya penentu kualitas, karena kualitas pelatihan juga berperan terhadap hasil model. Melalui pemilihan yang seimbang, TEKNOLOGI LLM offline dapat memberikan pengalaman yang lebih stabil.
Model Terkuantisasi Membuat LLM Offline Lebih Ringan
Quantization menjadi salah satu teknik penting untuk membuat LLM lebih ringan. Pada dasarnya, teknik ini menggunakan representasi numerik dengan presisi lebih rendah, sehingga ukuran model dapat diperkecil. Penghematan resource tersebut membuat TEKNOLOGI AI lokal semakin mudah diakses oleh perangkat konsumen.
Presisi model yang digunakan sebaiknya mempertimbangkan keseimbangan kualitas serta efisiensi. Kompresi parameter yang lebih kuat dapat memberikan penghematan memori lebih besar, tetapi berpotensi mempengaruhi kualitas keluaran. Untuk mendapatkan hasil yang seimbang, pengguna sebaiknya menguji beberapa konfigurasi hingga mendapatkan keseimbangan antara kualitas dan kecepatan.
Context Length yang Tepat Membantu LLM Bekerja Lebih Ringan
Context window menentukan seberapa banyak token yang dapat diproses dalam konteks. Context window berkapasitas tinggi memang membantu percakapan dengan riwayat besar, tetapi juga dapat menambah beban inferensi. Untuk komputer dengan VRAM kecil, menggunakan context maksimal sepanjang waktu dapat menekan resource yang tersedia.
Dalam penggunaan AI sehari hari, jumlah token yang disesuaikan sering cukup memadai. Pengguna dapat meningkatkan batasnya ketika diperlukan daripada langsung menggunakan nilai tertinggi. Pengaturan seperti ini membantu memberikan lebih banyak ruang bagi sistem sekaligus membuat inferensi lokal terasa lebih responsif.
Pembagian CPU dan GPU Menentukan Efisiensi Inferensi
Pemroses grafis dapat membantu mempercepat inferensi apabila software memiliki dukungan akselerasi. Namun, tidak semua komputer memiliki VRAM besar. Jika model melebihi kapasitas VRAM, pengguna dapat menempatkan sebagian komputasi pada kartu grafis daripada menghabiskan seluruh VRAM.
Jumlah layer yang diarahkan ke GPU dapat disesuaikan secara bertahap. Apabila memori GPU mencukupi, lebih banyak bagian model dapat diproses melalui GPU. Sebaliknya, jika VRAM hampir penuh, sistem dapat menggunakan kombinasi CPU serta GPU. Pembagian resource yang tepat dapat menghasilkan pengalaman inferensi yang lebih nyaman.
Konfigurasi Sistem yang Ringan Membantu LLM Berjalan Lebih Lancar
Konfigurasi CPU serta GPU bukan satu satunya bagian dari optimasi. Runtime yang digunakan juga dapat memberikan pilihan konfigurasi yang berbeda. Runtime yang efisien dapat memanfaatkan kemampuan CPU dan GPU dengan lebih baik, sehingga model terasa lebih responsif.
Jumlah aplikasi yang berjalan juga perlu diperhatikan. Browser dengan banyak tab dapat bersaing menggunakan memori dengan LLM. Menutup aplikasi yang tidak dibutuhkan merupakan cara praktis meningkatkan ruang tersedia. Dengan menggabungkan optimasi software dan hardware, TEKNOLOGI AI lokal dapat digunakan tanpa selalu membutuhkan komputer kelas workstation.
Kesimpulan, LLM Lokal Bisa Berjalan Nyaman dengan Konfigurasi yang Seimbang
Mengoptimalkan AI lokal memerlukan pengaturan resource yang tepat. Menentukan LLM secara realistis, pengurangan presisi, penyesuaian panjang konteks, serta pembagian CPU dan GPU dapat menjaga sistem tetap responsif. Tidak selalu diperlukan hardware termahal selama pengguna memahami batas hardware.
Dalam perkembangan berikutnya, TEKNOLOGI LLM lokal kemungkinan semakin efisien melalui model yang lebih ringkas. Dari pengalaman Anda, optimasi mana yang paling efektif mengurangi penggunaan memori, apakah quantization? Berikan perspektif Anda mengenai penggunaan AI offline dan ikuti pembahasan berikutnya untuk mengikuti perkembangan AI lokal yang semakin efisien.


